文章目錄
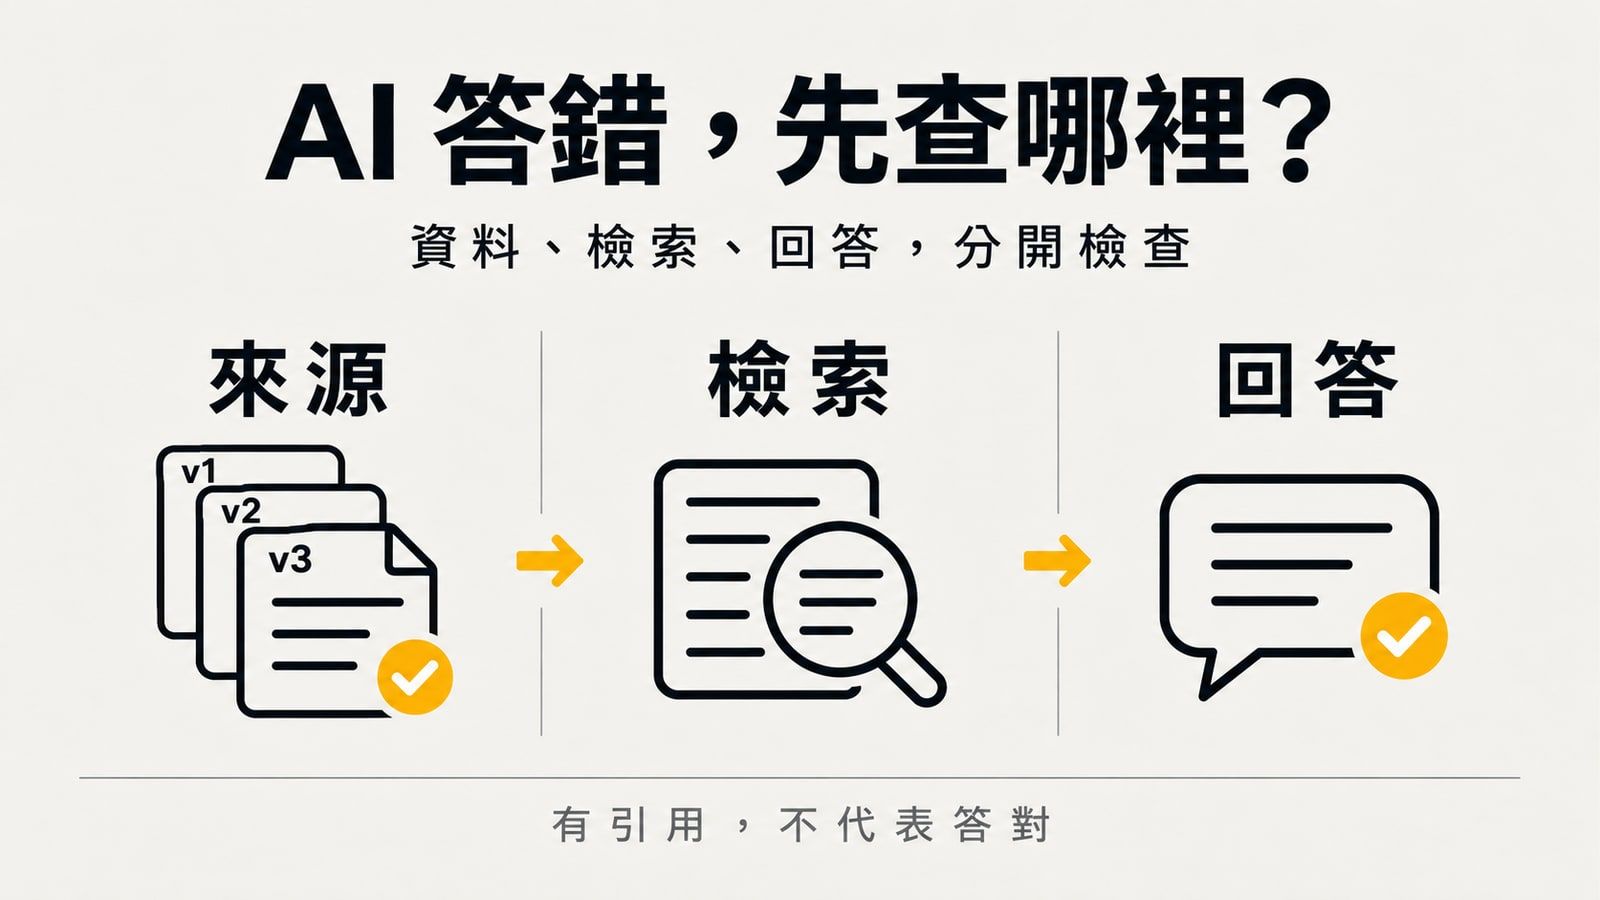
AI 知識庫答錯時,先問「它讀到什麼」,再問「它怎麼回答」。
文件上傳成功,只證明系統接受了檔案,不代表內文、表格、適用條件與版本都被正確使用。反覆加入「請務必正確」的提示詞,也無法補回根本沒有被找到的資料。
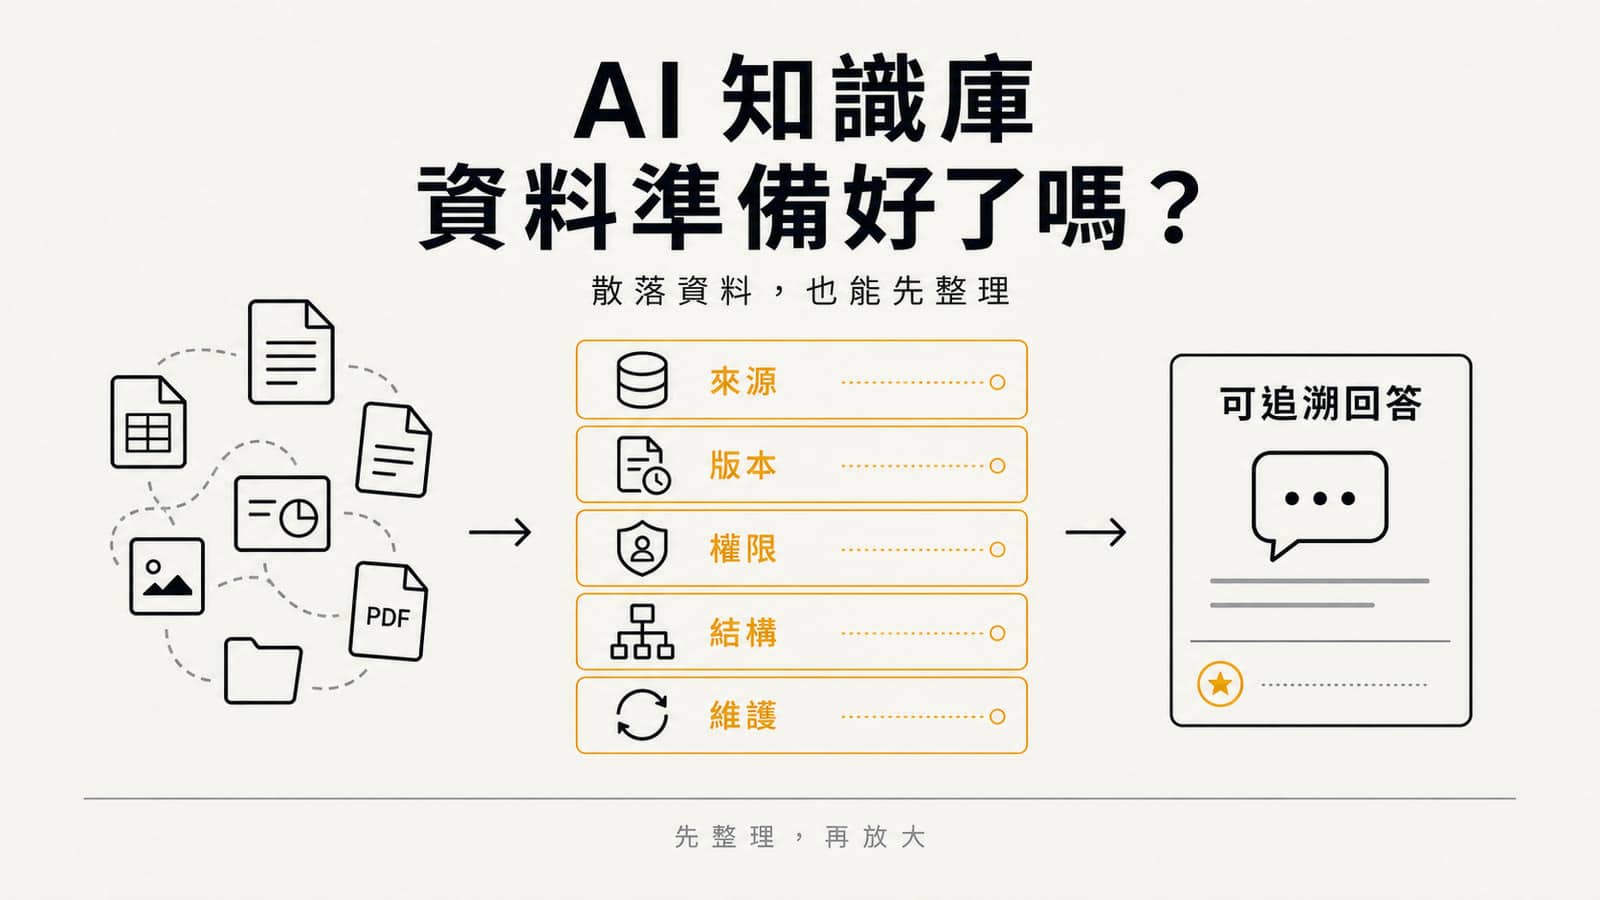
這篇聚焦在已經做出知識庫、開始遇到錯誤的階段。若還在整理檔案,可先看企業資料分散時,如何準備 AI 知識庫。
先保存一個能重查的錯誤
不要只截下最後一句回答,就請工程師「調整一下 AI」。建議每次錯誤至少留下以下紀錄,並依資料敏感程度限制存取與保存期限。
| 紀錄 | 要能回答的問題 |
|---|---|
| 使用者問題與必要上下文 | 原本在問哪個產品、日期、地區或客戶類型? |
| 預期答案與確認人 | 誰確認這個答案有效,依據在哪裡? |
| 文件版本與適用期間 | 系統使用的是哪一份規則? |
| 實際找到的段落 | 關鍵條件有沒有進入回答的上下文? |
| 回答與引用 | 哪一句錯誤、遺漏或超出證據? |
| 系統設定版本 | 當時的檢索、提示詞與模型設定是什麼? |
可以用去識別化的問題重現,不要為了除錯,把整批客戶資料複製到沒有管控的共用文件。紀錄的目標是還原問題,不是無限制地收集所有對話。
第一層:來源本身能回答嗎?
假設使用者問某項產品是否包含到場服務。文件只有「支援安裝」四個字,沒有說明線上指導、現場施工、適用地區或額外費用。此時不是 AI 少理解一點,而是正式答案尚未被寫清楚。
先請內容負責人確認:
- 同一個問題是否存在兩份互相矛盾的規則。
- 舊版是否仍被當成現行文件。
- 掃描 PDF 的文字、表格欄位與註腳是否完整解析。
- 產品名稱、別名與適用條件是否有明確對應。
- 機密或無權限的資料是否在檢索前就被排除。
若文件互相衝突,應先指定有效來源或轉人工確認,不要把「採用日期最新的一份」當成任何情境都適用的規則。新的草稿也可能尚未生效。
第二層:答案存在,但有被找到嗎?
檢索增強生成,也就是 RAG,會先找相關資料,再讓模型根據這些資料產生回答。因此要把「找不到正確段落」與「找到之後理解錯誤」拆開檢查。
可以請開發者用同一個問題展示實際取回的內容,特別注意三種情況:
- 名稱不同:客戶使用俗稱,文件只寫正式品名。
- 條件被拆散:主要條款與「不適用」的註腳分到不同段落。
- 篩選錯誤:應該使用的版本被排除,或不該出現的資料混入結果。
對應的改善可能是補上別名、調整文件切分方式,或修正篩選條件。不是每次都增加取回段落的數量;加入更多內容也可能帶入無關或互相矛盾的資訊。
Microsoft 的 RAG 評估指南也將前段檢索品質與後段回答評估分開處理。實務上可借用這個區分,但檢查題與合格標準仍要依自己的工作設計。
第三層:有依據,回答卻把條件省略了
假設文件寫「標準方案提供平日遠端支援,現場服務另行報價」,回答卻變成「標準方案包含現場支援」。即使附上正確文件連結,這個結論仍與來源不符。
回答階段要檢查的不只是語句順不順:
| 檢查方向 | 實際核對方式 |
|---|---|
| 有沒有依據 | 每個關鍵結論是否能對到支持它的段落 |
| 有沒有漏條件 | 期間、例外、費用與適用對象是否保留 |
| 有沒有回答問題 | 使用者問的是能否辦理,還是如何申請 |
| 有沒有越界 | 是否自行承諾價格、交期或未授權的處理方式 |
依據完整卻持續誤讀時,再評估提示詞、回答格式或模型差異。調整時保留原本的測試題,避免只是讓某個展示問題變好,其他問題反而退步。
把「不知道」也納入正常流程
好的知識庫不必每題都有答案,但應讓使用者知道接下來能做什麼。
例如缺少產品版本,可以先問版本;兩份有效規則衝突,應說明需由指定窗口確認;涉及個別承諾,則將已知資料整理給負責人覆核。拒答不應是冷冰冰的結束,而是有下一步的交接。
也不要直接把模型自己說的「九成把握」當成可對外回答的門檻。較務實的做法,是定義必要依據是否齊全、哪些條件必須確認,以及哪些類型一律保留人工決策。
用一小組題目反覆比較,而不是每次換問題
下面是建議的初始測試分類,不是固定題數或通用合格率。每一類都應放入實際會遇到的問法。
| 題目類型 | 預期行為 |
|---|---|
| 明確有答案 | 回答正確,保留條件並提供對應來源 |
| 使用口語別名 | 找到正確對象,不混成相似產品 |
| 缺少必要資訊 | 先澄清,不直接猜測 |
| 文件版本衝突 | 指出需確認,不任意選一份 |
| 沒有答案 | 說明限制並提供轉交方式 |
| 超出權限 | 不提供受限內容,也不洩露片段 |
評估紀錄至少分開寫「找對來源」「回答正確」「完整保留條件」「適當澄清或拒答」。同一題可測試多次,觀察結果是否穩定;不能用一個總平均掩蓋少數但嚴重的越權回答。
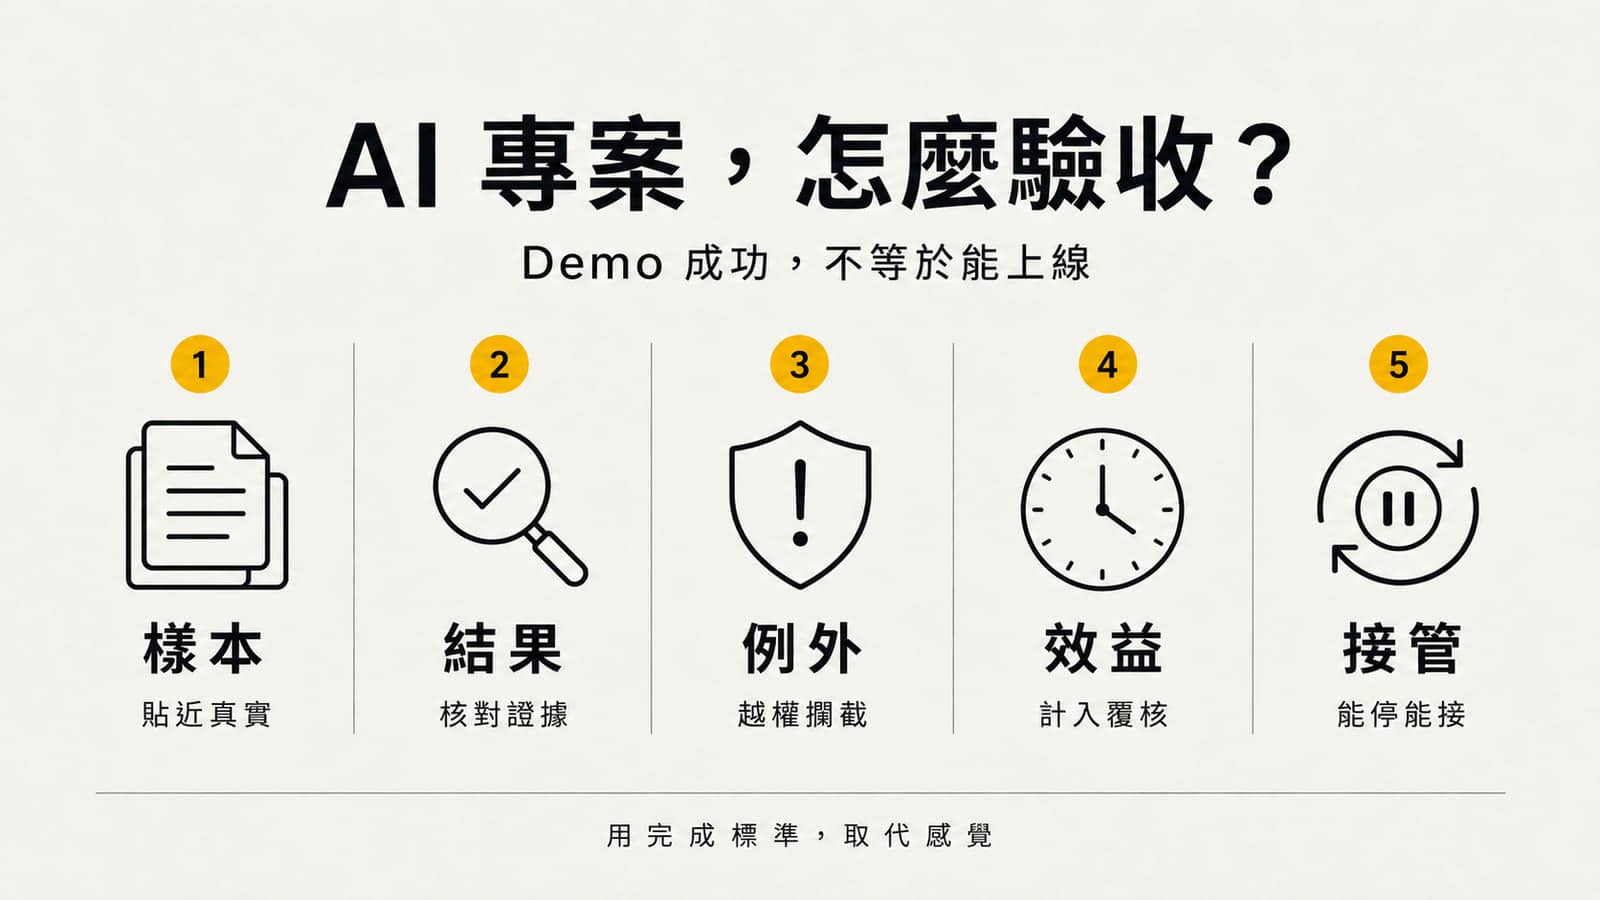
關於上線門檻與人工接管,可以接著看 AI 專案驗收前的五個關卡。
常見問題
AI 知識庫答錯,換更強的模型就能解決嗎?
不一定。若來源過期、文件解析遺漏或檢索沒有找到關鍵段落,換模型未必能補回缺失的資訊。應先保存一組可重現的問題與處理紀錄,分開檢查來源、檢索與生成,再用相同測試題比較調整前後的結果。
AI 回答附上引用連結,就代表內容正確嗎?
不代表。要檢查引用是否真的支持該句結論、版本是否有效,以及使用者是否有權限查看。回答可能引用正確文件卻漏掉適用條件,也可能忠於一份已過期的資料,因此引用只是核對入口,不是正確保證。
知識庫沒有答案時,應該讓 AI 自己推測嗎?
對產品規格、服務承諾或內部規則,不應把推測包裝成正式答案。可以說明目前缺少哪項資訊、提出必要的澄清問題,或轉交指定窗口;若提供一般性建議,必須與已確認的公司資訊清楚區分。
從一組錯誤開始,找出真正要改的地方
先整理幾筆具有代表性的錯誤、正確依據與人工處理方式,就能讓討論從「AI 不夠聰明」變成具體的改善項目。需要釐清卡在資料還是系統時,可以帶著去識別化的問題範例來討論。